VII. 参数估计

2024 年 12 月 17 日 (更新于 2025 年 1 月 13 日)

memset0
memset0
water_tomato
water_tomato

本篇笔记介绍了数理统计中参数估计的基本概念和方法。首先讲解了点估计的两种主要方法:矩估计法和极大似然估计法。接着详细阐述了评价估计量优劣的四个准则:无偏性、有效性、均方误差和相合性。最后介绍了区间估计的概念,重点讨论了置信区间和枢轴量,并通过实例说明了如何利用枢轴量构造置信区间。(由 claude-3.5-sonnet 生成摘要)

1. 参数估计

  • (参数) 反应总体某方面特征的量。
  • (参数估计) 当总体的参数未知时,利用样本资料对其给出估计。
  • (点估计) 设总体 XX 有未知参数 θ\theta,X1,⋯ ,XnX_{1},\cdots,X_{n} 是 XX 的简单随机样本。构造合适的统计量 θ^=θ^(x1,⋯ ,xn)\hat{\theta} = \hat{\theta}(x_{1},\cdots,x_{n}) 用来估计未知参数 θ\theta,称 θ^\hat{\theta} 为参数 θ\theta 的 点估计量,θ^(x1,⋯ ,xn)\hat{\theta}(x_{1},\cdots,x_{n}) 为参数 θ\theta 的 点估计值。
    • (矩估计法)
      • 统计思想:以样本矩估计总体矩,以样本矩的函数估计总体矩的函数。
        • 理论依据:辛钦大数定律和依概率收敛的性质。
      • 步骤:
        • ① 求总体前 kk 阶矩关于 kk 个参数的函数:μi=E(Xi)=hi(θ1,⋯ ,θk) (i=1,⋯ ,k)\mu_i=E(X^i)=h_i(\theta_1,\cdots,\theta_k)\ (i=1,\cdots,k)
        • ② 求各参数关于 kk 阶矩的反函数:θi=gi(μ1,⋯ ,μk) (i=1,⋯ ,k)\theta_i=g_i(\mu_1,\cdots,\mu_k)\ (i=1,\cdots,k)
        • ③ 以样本各阶矩 A1,⋯ ,AkA_{1},\cdots,A_{k} 代替总体各阶矩 μ1,⋯ ,μk\mu_{1},\cdots,\mu_{k} 得各参数的矩估计 θ^i=gi(A1,⋯ ,Ak) (i=1,⋯ ,k)\hat{\theta}_i=g_i(A_1,\cdots,A_k)\ (i=1,\cdots,k)
        • 在实际应用时,为求解方便,也可以用中心矩代替原点矩;采用的矩不同,得出的参数估计自然也不同。
    • (极大似然估计)
      • 设离散型总体 X∼p(x;θ), θ∈ΘX \sim p(x;\theta),\ \theta \in \Theta,θ\theta 未知,从总体 XX 中取得样本 X1,X2,⋯ ,XnX_{1},X_{2},\cdots,X_{n},其观察值为 x1,x2,⋯ ,xnx_{1},x_{2},\cdots,x_{n},则事件 {X1=x1,⋯ ,Xn=xn}\{ X_{1}=x_{1},\cdots,X_{n}=x_{n} \} 发生的概率为 L(θ)=P{X1=x1,⋯ ,Xn=xn}=p(x1;θ)⋯p(xn;θ)=∏i=1np(xi;θ)L(\theta) = P\{ X_{1}=x_{1},\cdots,X_{n}=x_{n} \} = p(x_{1}; \theta) \cdots p(x_{n}; \theta) = \displaystyle{\prod_{i=1}^{n} p(x_{i}; \theta)}。称 θ^(x1,⋯ ,xn)\hat{\theta}(x_{1},\cdots,x_{n}) 为 θ\theta 的 极大似然估计值,相应统计量 θ^(X1,⋯ ,Xn)\hat{\theta}(X_{1},\cdots,X_n) 为 θ\theta 的 极大似然估计量。
      • 极大似然原理:L(θ^(x1,x2,⋯ ,xn))=max⁡θ∈ΘL(θ)\displaystyle{L(\hat{\theta} (x_{1},x_{2},\cdots,x_{n})) = \max_{\theta \in \Theta} L(\theta)}。
      • 说明:
        • 未知参数可能不止一个,一般设为 θ=(θ1,θ2,⋯ ,θn)\theta=(\theta_{1},\theta_{2},\cdots,\theta_{n})。
        • 在求 L(θ)L(\theta) 的最大值时,通常转化为求 ln⁡L(θ)\ln L(\theta) 的最大值,其中 ln⁡L(θ)\ln L(\theta) 称为 对数似然函数。利用 ∂ln⁡L(θ)∂θi=0\dfrac{\partial \ln L(\theta)}{\partial \theta_{i}}=0 解得 θi^\hat{\theta_{i}}。
        • 若 L(θ)L(\theta) 关于某个 θi\theta_{i} 是单调增(减)函数,此时 θi\theta_{i} 的极大似然估计在其边界取得。
        • 若 θ^\hat{\theta} 是 θ\theta 的极大似然估计,则 g(θ)g(\theta) 的极大似然估计为 g(θ^)g(\hat{\theta})。

2. 估计量的评选准则

  • (无偏性准则) 若参数 θ\theta 的估计量 θ^=θ^(X1,X2,⋯ ,Xn)\hat{\theta} = \hat{\theta} (X_{1},X_{2},\cdots,X_{n}),满足 E(θ^)=θE(\hat{\theta})=\theta,则称 θ^\hat{\theta} 是 θ\theta 的一个 无偏估计量。
    • 若 E(θ^)≠θE(\hat{\theta})\neq \theta,那么 ∣E(θ^)−θ∣\left| E(\hat{\theta}) - \theta \right| 称为估计量 θ^\hat{\theta} 的 偏差。
    • 若 lim⁡n→∞E(θ^)=θ\displaystyle{\lim_{ n \to \infty } E(\hat{\theta}) = \theta},则称 θ^\hat{\theta} 是 θ\theta 的 渐进无偏估计量。
    • 纠偏:若 E(θ^)=aθ+b, θ∈ΘE(\hat{\theta}) = a \theta + b,\ \theta \in \Theta,其中 a,ba,b 是常数且 a≠0a\neq0,则 1a(θ^−b)\dfrac{1}{a} (\hat{\theta} - b) 是 θ\theta 的无偏估计。
  • (有效性准则) 设 θ^1,θ^2\hat{\theta}_{1}, \hat{\theta}_{2} 是 θ\theta 的两个无偏估计,如果 D(θ^1)≤D(θ^2)D(\hat{\theta}_{1}) \leq D(\hat{\theta}_{2}),对一切 θ∈Θ\theta \in \Theta 成立,且不等号至少对某一 θ∈Θ\theta \in \Theta 成立,则称 θ^1\hat{\theta}_{1} 比 θ^2\hat{\theta}_2 有效。
  • (均方误差准则) 设 θ^\hat{\theta} 是参数 θ\theta 的点估计,方差存在,则称 E((θ^−θ)2)E\left(\left( \hat{\theta} - \theta \right)^{2}\right) 是估计量的均方误差,记为 Mse(θ^)Mse(\hat{\theta})。若 θ^\hat{\theta} 是 θ\theta 的无偏估计,则有 Mse(θ^)=D(θ^)Mse(\hat{\theta}) = D(\hat{\theta})。
  • (相合性准则) 设 θ^(X1,X2,⋯ ,Xn)\hat{\theta}(X_{1},X_{2},\cdots,X_{n}) 为参数 θ\theta 的估计量,若对于任意 θ∈Θ\theta \in \Theta,当 n→+∞n\to+\infty 时,θ^n\hat{\theta}_{n} 依概率收敛于 θ\theta,即 ∀ε>0\forall \varepsilon>0,有 lim⁡n→∞P{θ^n−θ}≥ε=0\displaystyle{\lim_{ n \to \infty } P\left\{ \hat{\theta}_{n} - \theta \right\} \geq \varepsilon} = 0 成立,则称 θ^n\hat{\theta}_{n} 为 θ\theta 的 相合估计量 或 一致估计量。
    • 根据依概率收敛的性质,由 A1,⋯ ,AkA_{1},\cdots,A_{k} 是 μ1,⋯ ,μk\mu_{1},\cdots,\mu_{k} 的相合估计,若 g(μ1,⋯ ,μk)g(\mu_{1},\cdots,\mu_{k}) 是连续函数,则 g(A1,⋯ ,Ak)g(A_{1},\cdots,A_{k}) 是 g(μ1,⋯ ,μk)g(\mu_{1},\cdots,\mu_{k}) 的 相合估计。

3. 区间估计

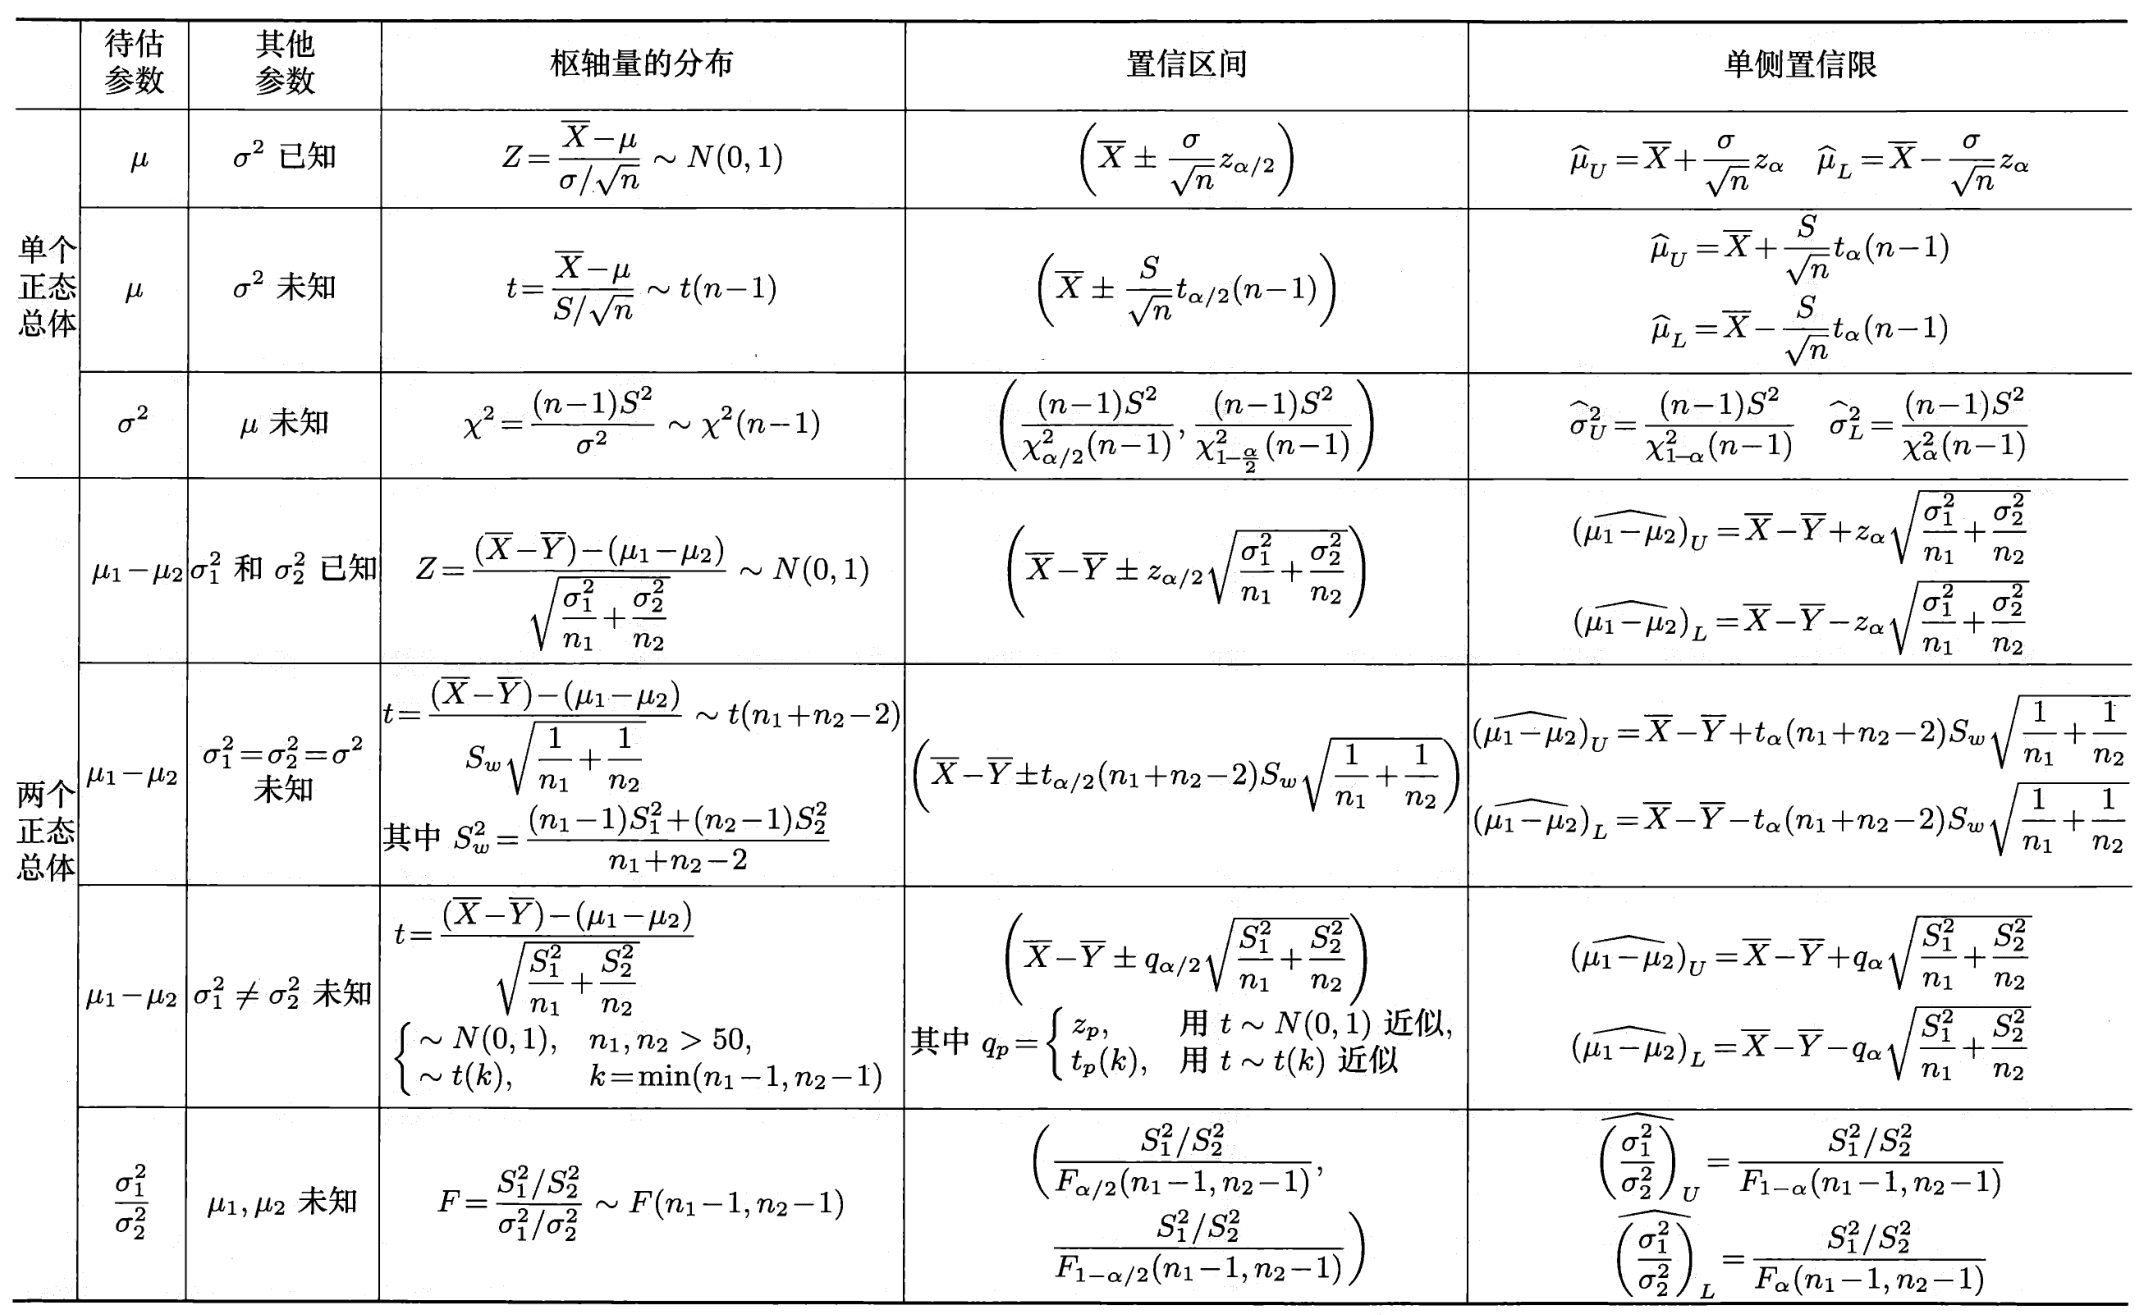
置信区间是可以通过枢轴量推出的,建议掌握这样可以大大减少期末考试时的记忆量。

  • (置信区间) 设总体 XX 的分布函数 F(x;θ)F(x;\theta) 含有一个未知参数 θ\theta,(X1,⋯ ,Xn)(X_{1},\cdots,X_{n}) 是总体 XX 的一个样本,对给定的值 α (0<α<1)\alpha\ (0<\alpha<1),如果有两个统计量 θ^L=θ^L(X1,⋯ ,Xn)\hat{\theta}_{L} = \hat{\theta}_{L} (X_{1},\cdots,X_{n}),θ^U=θ^U(X1,⋯ ,Xn)\hat{\theta}_{U}= \hat{\theta}_{U}(X_{1},\cdots,X_{n}),使得:P{θ^L(X1,⋯ ,Xn)<θ<θ^U(X1,⋯ ,Xn)}≥1−α (∀θ∈Θ)P\left\{ \hat{\theta}_{L} (X_{1},\cdots,X_{n}) < \theta < \hat{\theta}_{U}(X_{1},\cdots,X_{n}) \right\} \geq 1 - \alpha\ (\forall \theta \in \Theta)。则称随机区间 (θ^L,θ^U)\left( \hat{\theta}_{L}, \hat{\theta}_{U} \right) 是 θ\theta 的 双侧置信区间,称 1−α1-\alpha 为 置信度,θ^L\hat{\theta}_{L} 为 双侧置信下限,θ^U\hat{\theta}_{U} 为 双侧置信上限。
  • (枢轴量) 设总体 XX 的概率密度函数 f(x;θ)f(x;\theta),其中 θ\theta 为待估参数,并设 X1,X2,⋯ ,XnX_{1},X_{2},\cdots,X_{n} 是来自总体 XX 的样本,如果样本和参数 θ\theta 的函数 G(X1,X2,⋯ ,Xn;θ)G(X_{1},X_{2},\cdots,X_{n}; \theta) 的分布完全已知,且形式上不依赖于其他未知参数,则称 G(X1,X2,⋯ ,Xn;θ)G(X_{1},X_{2},\cdots,X_{n};\theta) 为 枢轴量。
    • 单个正态总体时的假设检验的枢轴量:
      • 待估 μ\mu,σ2\sigma^{2} 已知:Z=X‾−μ0σ/n∼N(0,1)\displaystyle{Z=\frac{\overline{X}-\mu_0}{\sigma/\sqrt{n}}} \sim N(0,1);
      • 待估 μ\mu,σ2\sigma^{2} 未知:T=X‾−μ0S/n∼t(n−1)T=\dfrac{\overline{X}-\mu_0}{S/\sqrt{n}} \sim t(n-1);
      • 待估 σ2\sigma^{2},μ\mu 未知:χ2=(n−1)S2σ2∼χ2(n−1)\displaystyle{\chi^2=\frac{(n-1)S^2}{\sigma^2}\sim\chi^2(n-1)};
    • 两个正态总体时的假设检验的枢轴量:
      • 待估 μ1−μ2\mu_{1}-\mu_{2},σ12\sigma^{2}_{1} 和 σ22\sigma^{2}_{2} 已知:Z=(X‾−Y‾)−(μ1−μ2)σ12n1+σ22n2∼N(0,1)Z=\dfrac{(\overline{X}-\overline{Y})-(\mu_1-\mu_2)}{\sqrt{\dfrac{\sigma_1^2}{n_1}+\dfrac{\sigma_2^2}{n_2}}}\sim N(0,1);
      • 待估 μ1−μ2\mu_{1}-\mu_{2},σ12=σ22\sigma^{2}_{1}=\sigma^{2}_{2} 未知:t=(X‾−Y‾)−(μ1−μ2)Sw1n1+1n2∼t(n1+n2−2)t=\dfrac{(\overline{X}-\overline{Y})-(\mu_{1}-\mu_{2})}{S_{w}\sqrt{\dfrac{1}{n_{1}}+\dfrac{1}{n_{2}}}}\sim t(n_{1}+n_{2}-2),其中 Sw2=(n1−1)S12+(n2−1)S22n1+n2−2S_{w}^{2}=\dfrac{(n_{1}-1)S_{1}^{2}+(n_{2}-1)S_{2}^{2}}{n_{1}+n_{2}-2};
      • 待估 σ12σ22\dfrac{\sigma^{2}_{1}}{\sigma^{2}_{2}},μ1,μ2\mu_{1},\mu_{2} 未知:F=S12/S22σ12/σ22∼F(n1−1,n2−1)\displaystyle{F=\frac{S_{1}^{2}/S_{2}^{2}}{\sigma_{1}^{2}/\sigma_{2}^{2}}\sim F(n_{1}-1,n_{2}-1)};
    • 其余的仅了解即可,考试不考察。

根据枢轴量推出置信区间和单侧置信限(以待估 μ\mu,σ2\sigma^{2} 已知的情况为例)

  • Z=X‾−μ0σ/n∼N(0,1)\displaystyle{Z=\frac{\overline{X}-\mu_0}{\sigma/\sqrt{n}}} \sim N(0,1),故落在 (zα/2,z1−α/2)\left( z_{\alpha / 2}, z_{1-\alpha / 2} \right) 中的概率恰为 1−α1-\alpha;
  • zα/2<X‾−μ0σ/n<z1−α/2\displaystyle{z_{\alpha / 2} < \dfrac{\overline{X}-\mu_0}{\sigma/\sqrt{n}} < z_{1-\alpha/2}}
  •   ⟹  σnzα/2<X‾−μ0<σnz1−α/2\displaystyle{\implies \dfrac{\sigma}{\sqrt{n}} z_{\alpha / 2} < \overline{X}-\mu_0 < \dfrac{\sigma}{\sqrt{n}} z_{1-\alpha/2}}
  •   ⟹  X‾+σnz1−α/2<μ0<X‾+σnzα/2\displaystyle{\implies \overline{X} + \dfrac{\sigma}{\sqrt{n}} z_{1-\alpha/2} < \mu_0 < \overline{X} + \dfrac{\sigma}{\sqrt{n}} z_{\alpha / 2}}
  • 这样就得到了置信区间为:X‾+σnz1−α/2<μ0<X‾+σnzα/2\overline{X} + \dfrac{\sigma}{\sqrt{n}} z_{1-\alpha/2} < \mu_0 < \overline{X} + \dfrac{\sigma}{\sqrt{n}} z_{\alpha / 2}

评论

TABLE OF CONTENTS

1. 参数估计
2. 估计量的评选准则
3. 区间估计

© 2018-2026 memset0.

All rights reserved.

Source Code

Built with Gatsby.js


Made with ❤️ in China